NRC - Gestión de la información: estandarización de datos
Estandarización de datos
- Cliente
- NRC
- Periodo
- Sep 2025–Mar 2026
- Equipo
- 1 persona
- Servicios
- Gestión de la información y MEAL
- Tecnologías
- Python, Mistral
- Sector
- Humanitarian Aid & International Development
- ODS
- 2. Zero hunger, 3. Good health and well-being, 4. Quality education, 6. Clean water and sanitation
- Sitio web del cliente
- nrc.no
Como parte de la agenda más amplia de transformación digital del Consejo Noruego para Refugiados (NRC), el Departamento de Programas lleva a cabo una iniciativa estratégica para estructurar y digitalizar sus procesos de implementación y sus flujos de datos en terreno. En las oficinas de país, los equipos de programas dependen de una variedad de formularios y flujos de trabajo desarrollados localmente para gestionar las actividades, lo que genera datos fragmentados, formatos incoherentes y una interoperabilidad limitada. Esta falta de armonización dificulta que NRC analice sus datos operativos a nivel global, garantice una gestión de la información conforme al RGPD y tome decisiones programáticas informadas y basadas en evidencia. La consultoría de estandarización de la gestión de la información se puso en marcha para cerrar esta brecha entre los marcos de datos globales y las prácticas en los países.
Partiendo del trabajo de estandarización global ya iniciado en la sede, donde se definieron los objetos de datos y las taxonomías centrales, esta consultoría comenzó recopilando las herramientas que se usan actualmente en las operaciones de país de NRC para identificar patrones de flujo de trabajo recurrentes en tipos de actividad previamente identificados, extraer los datos subyacentes y compararlos con los estándares globales de datos de NRC. Así, el proceso contribuirá a validar, y posiblemente ampliar, los estándares de datos de NRC y sentará las bases de una biblioteca unificada de herramientas estandarizadas para la recolección de datos durante la prestación de servicios.
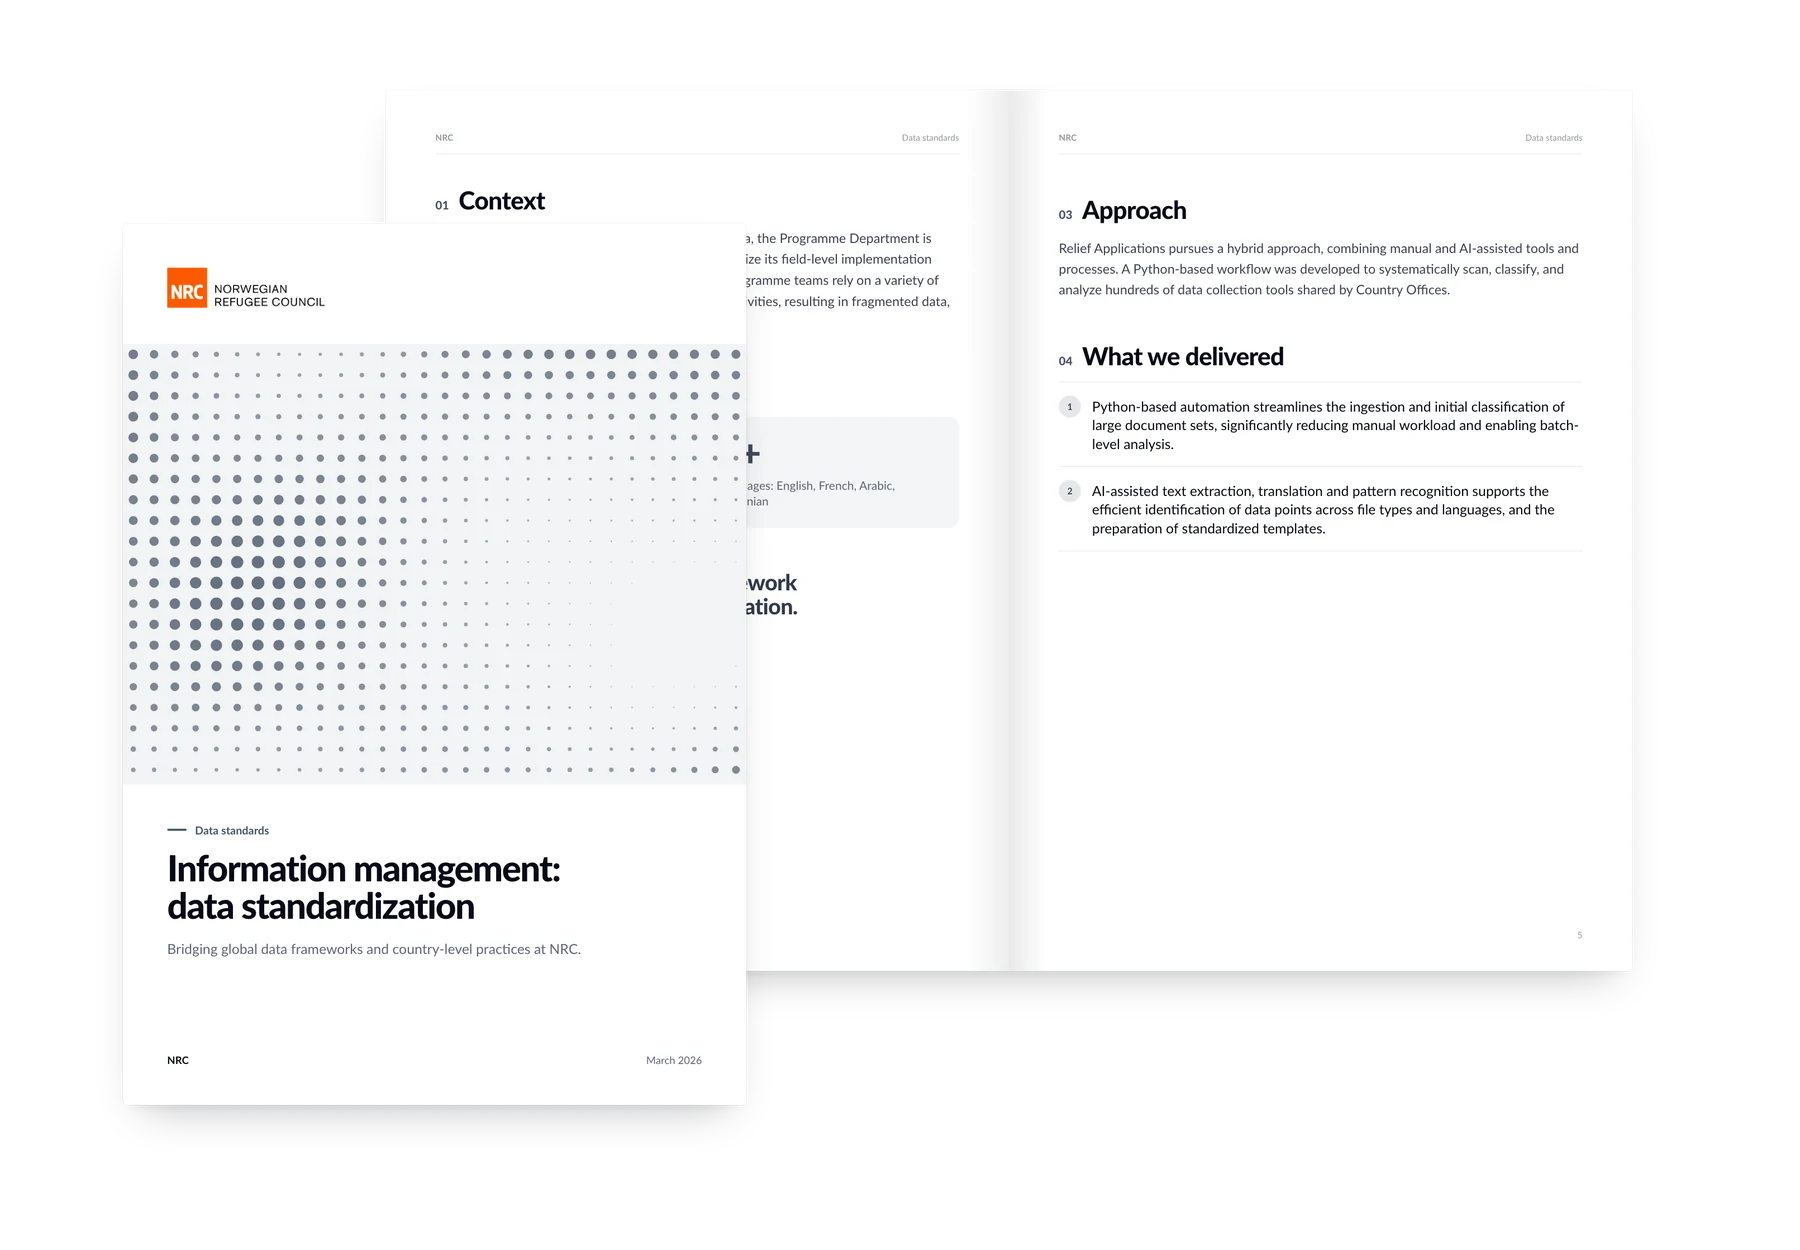
Relief Applications sigue un enfoque híbrido que combina herramientas y procesos manuales y asistidos por IA. Se desarrolló un flujo de trabajo en Python para escanear, clasificar y analizar de forma sistemática cientos de herramientas de recolección de datos compartidas por las oficinas de país. Se utilizan técnicas de extracción de texto y de reconocimiento de patrones asistidas por IA para identificar datos comunes, estructuras de formulario recurrentes y fases de flujo de trabajo en los documentos. Este enfoque híbrido, que integra la automatización con la validación experta, garantiza a la vez rigor analítico y un uso eficiente de los recursos. Además, ofrece un marco replicable y escalable que puede volver a aplicarse en futuras rondas de estandarización o extenderse a otras áreas temáticas y unidades de la organización.
El reto
- Gran número de formularios de recolección de datos por revisar (más de 1.500 entre países y competencias principales).
- Gran heterogeneidad de formatos (.xls, .pdf, .doc/.docx) e idiomas (inglés, francés, árabe, ucraniano y otros), lo que complica el análisis y la comparación automatizados.
Lo que hicimos
- La automatización en Python agiliza la ingesta y la clasificación inicial de grandes conjuntos de documentos, reduce de forma significativa el trabajo manual y permite el análisis por lotes.
- La extracción de texto, la traducción y el reconocimiento de patrones asistidos por IA facilitan la identificación eficiente de datos en distintos tipos de archivo e idiomas, y la preparación de plantillas estandarizadas.
Más proyectos
- MSF UK - REMIT: revisión de la herramienta de gestión e impacto de la investigación: MSF UK
- Equality Fund - Impact Library: datos, historias y análisis: Equality Fund
- FIDH - Sistema automatizado de gestión de hojas de tiempo: FIDH
- Cruz Roja Francesa - Plateforme Alimentaire de Guyane: French Red Cross
- PUI - Respuesta rápida y acción anticipatoria en el Extremo Norte de Camerún: Première Urgence Internationale
- Expertise France - Sistema de datos MEAL para el proyecto EFOR: Expertise France